读懂 CuTe 的 Layout Product:从重复三个元素,到组织线程与数据
假设有三个连续的位置:
0 1 2
现在想沿用这三个位置的排列方式,再排出四组:
[0  1  2]  [3  4  5]  [6  7  8]  [9  10  11]
   第 0 组     第 1 组     第 2 组      第 3 组
CuTe 可以用一行代码描述这件事:
auto p = logical_product(make_layout(_3{}), make_layout(_4{}));
结果是 (3,4):(1,3)。第一个坐标选组内的元素,第二个坐标选哪一组。
Layout product 最初就是这样一个问题:已有一份排列规则,怎样把它重复到更大的范围? 后面的 zipped_product、tiled_product、blocked_product 等,都可以从这里往下理解。
下面先把这一行算清楚,再给原布局加上空隙,最后扩展到二维布局和线程分工。文中的数字表示 Layout 的输出偏移,不是 tensor 中保存的数据值;product 本身只构造映射,不分配存储,也不搬运数据。
从 3:1 和 4:1 开始
先约定本文的写法:
shape : stride
3:1 表示长度为 3、步长为 1 的布局,输入 i=0,1,2 时,输出依次为 0,1,2。4:1 同理。
CuTe 把一个维度叫作 mode。mode 可以嵌套,例如 (2,3) 也可以被放进一个更大的 mode 中。_3{} 表示编译期常量 3,下面的代码都在 using namespace cute; 下使用。
把刚才的一行展开:
auto a = make_layout(_3{}, _1{}); // 3:1
auto b = make_layout(_4{}, _1{}); // 4:1
auto p = logical_product(a, b);  // (3,4):(1,3)
这里 a 描述一组内部的排列,b 描述这些组的数量和次序。为了方便,后面也把一组称为一个 block。
结果有两个 mode,坐标 (i,j) 的计算方式是:
p(i,j) = i + 3*j

i:组内编号,0~2
j:分组编号,0~3
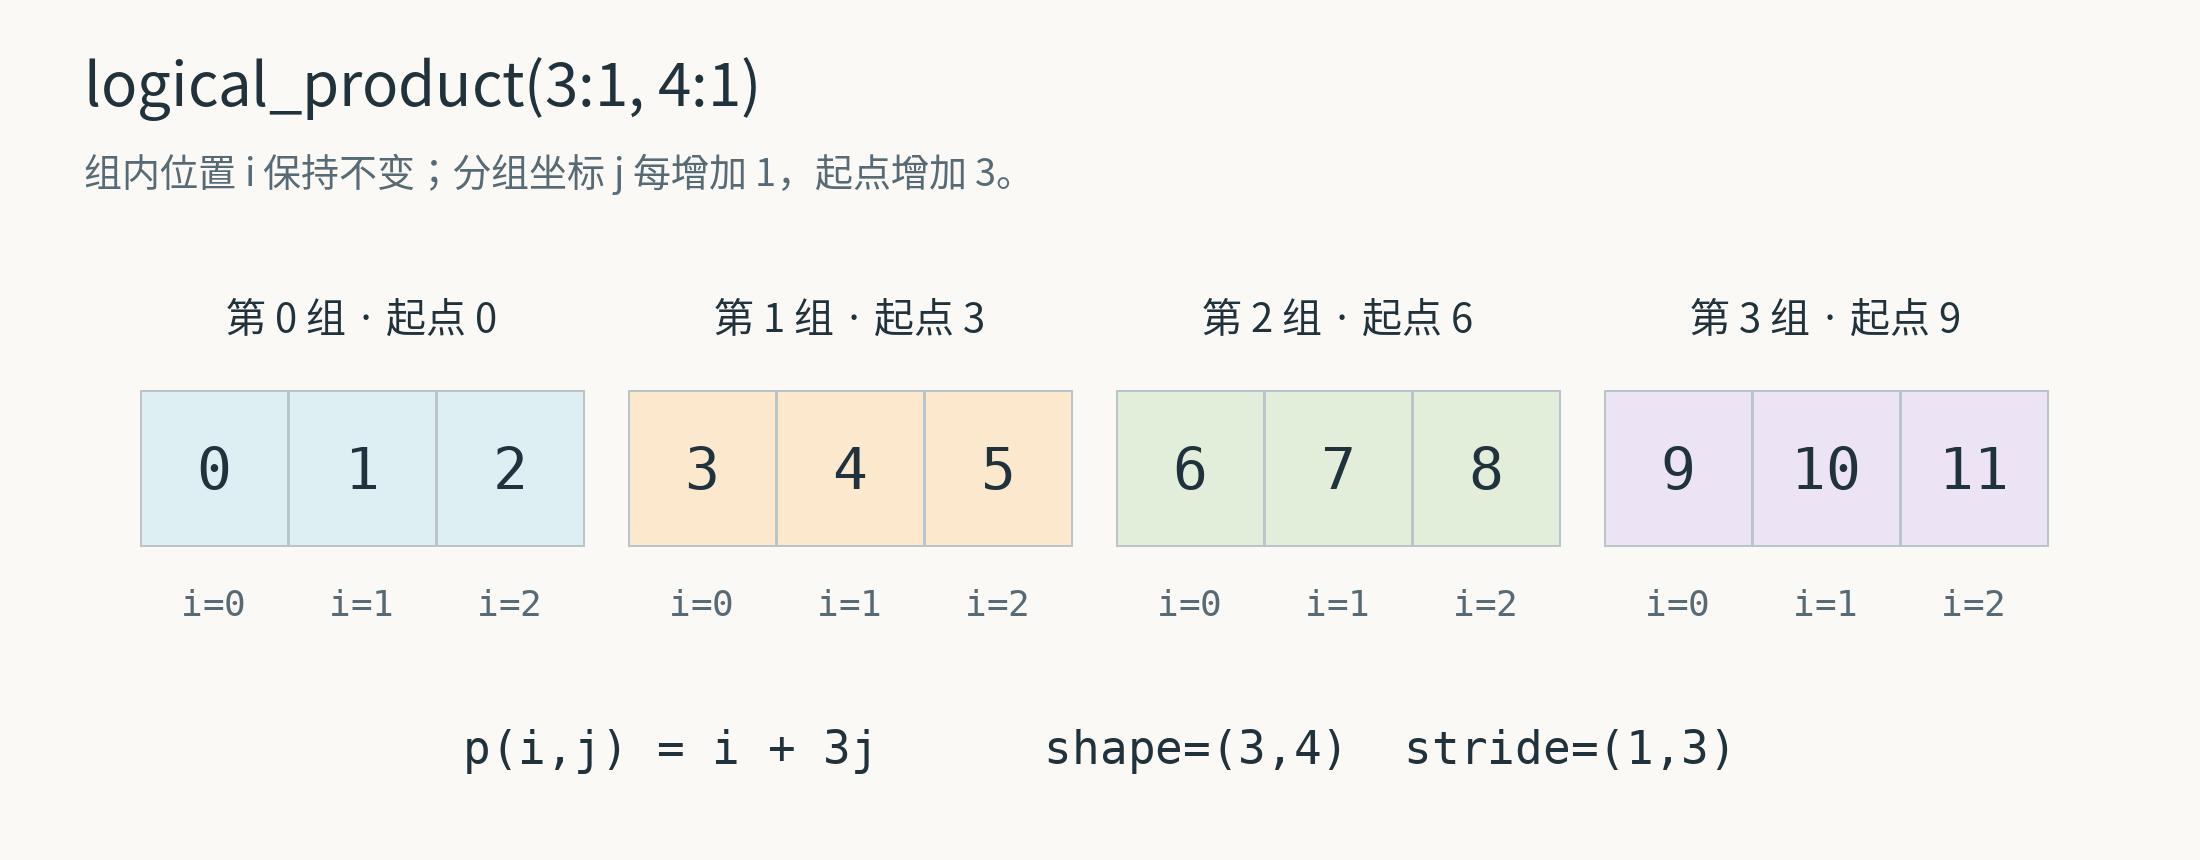
例如:
p(0,0); // 0
p(2,0); // 2
p(0,1); // 3
p(2,3); // 11
原布局沿 i 走一步增加 1,这个规则保留了下来。新增的 j 每走一步增加 3,恰好越过一整组。
所以 (3,4):(1,3) 可以读成:每组 3 个元素,共 4 组;组内步长为 1,组间步长为 3。
这时很容易猜出一个公式:“把第二个布局的 stride 乘以 size(a) 就行了。”对于这个连续布局,确实如此。但换一个 a,这个猜法就不够用了。
原布局有空隙,下一组应该放在哪里
把 a 改成 3:2:
auto a = make_layout(_3{}, _2{}); // 输出 0、2、4
auto b = make_layout(_4{}, _1{});
auto p = logical_product(a, b);
第一组占据 0、2、4,中间空着 1、3。下一组有两种看起来都说得通的放法:从 6 开始,或者先用上这些空隙。
CuTe 的结果采用后者:
| 分组编号 j | 这一组的起点 | 三个输出偏移 |
|---|---|---|
| 0 | 0 | 0,2,4 |
| 1 | 1 | 1,3,5 |
| 2 | 6 | 6,8,10 |
| 3 | 7 | 7,9,11 |
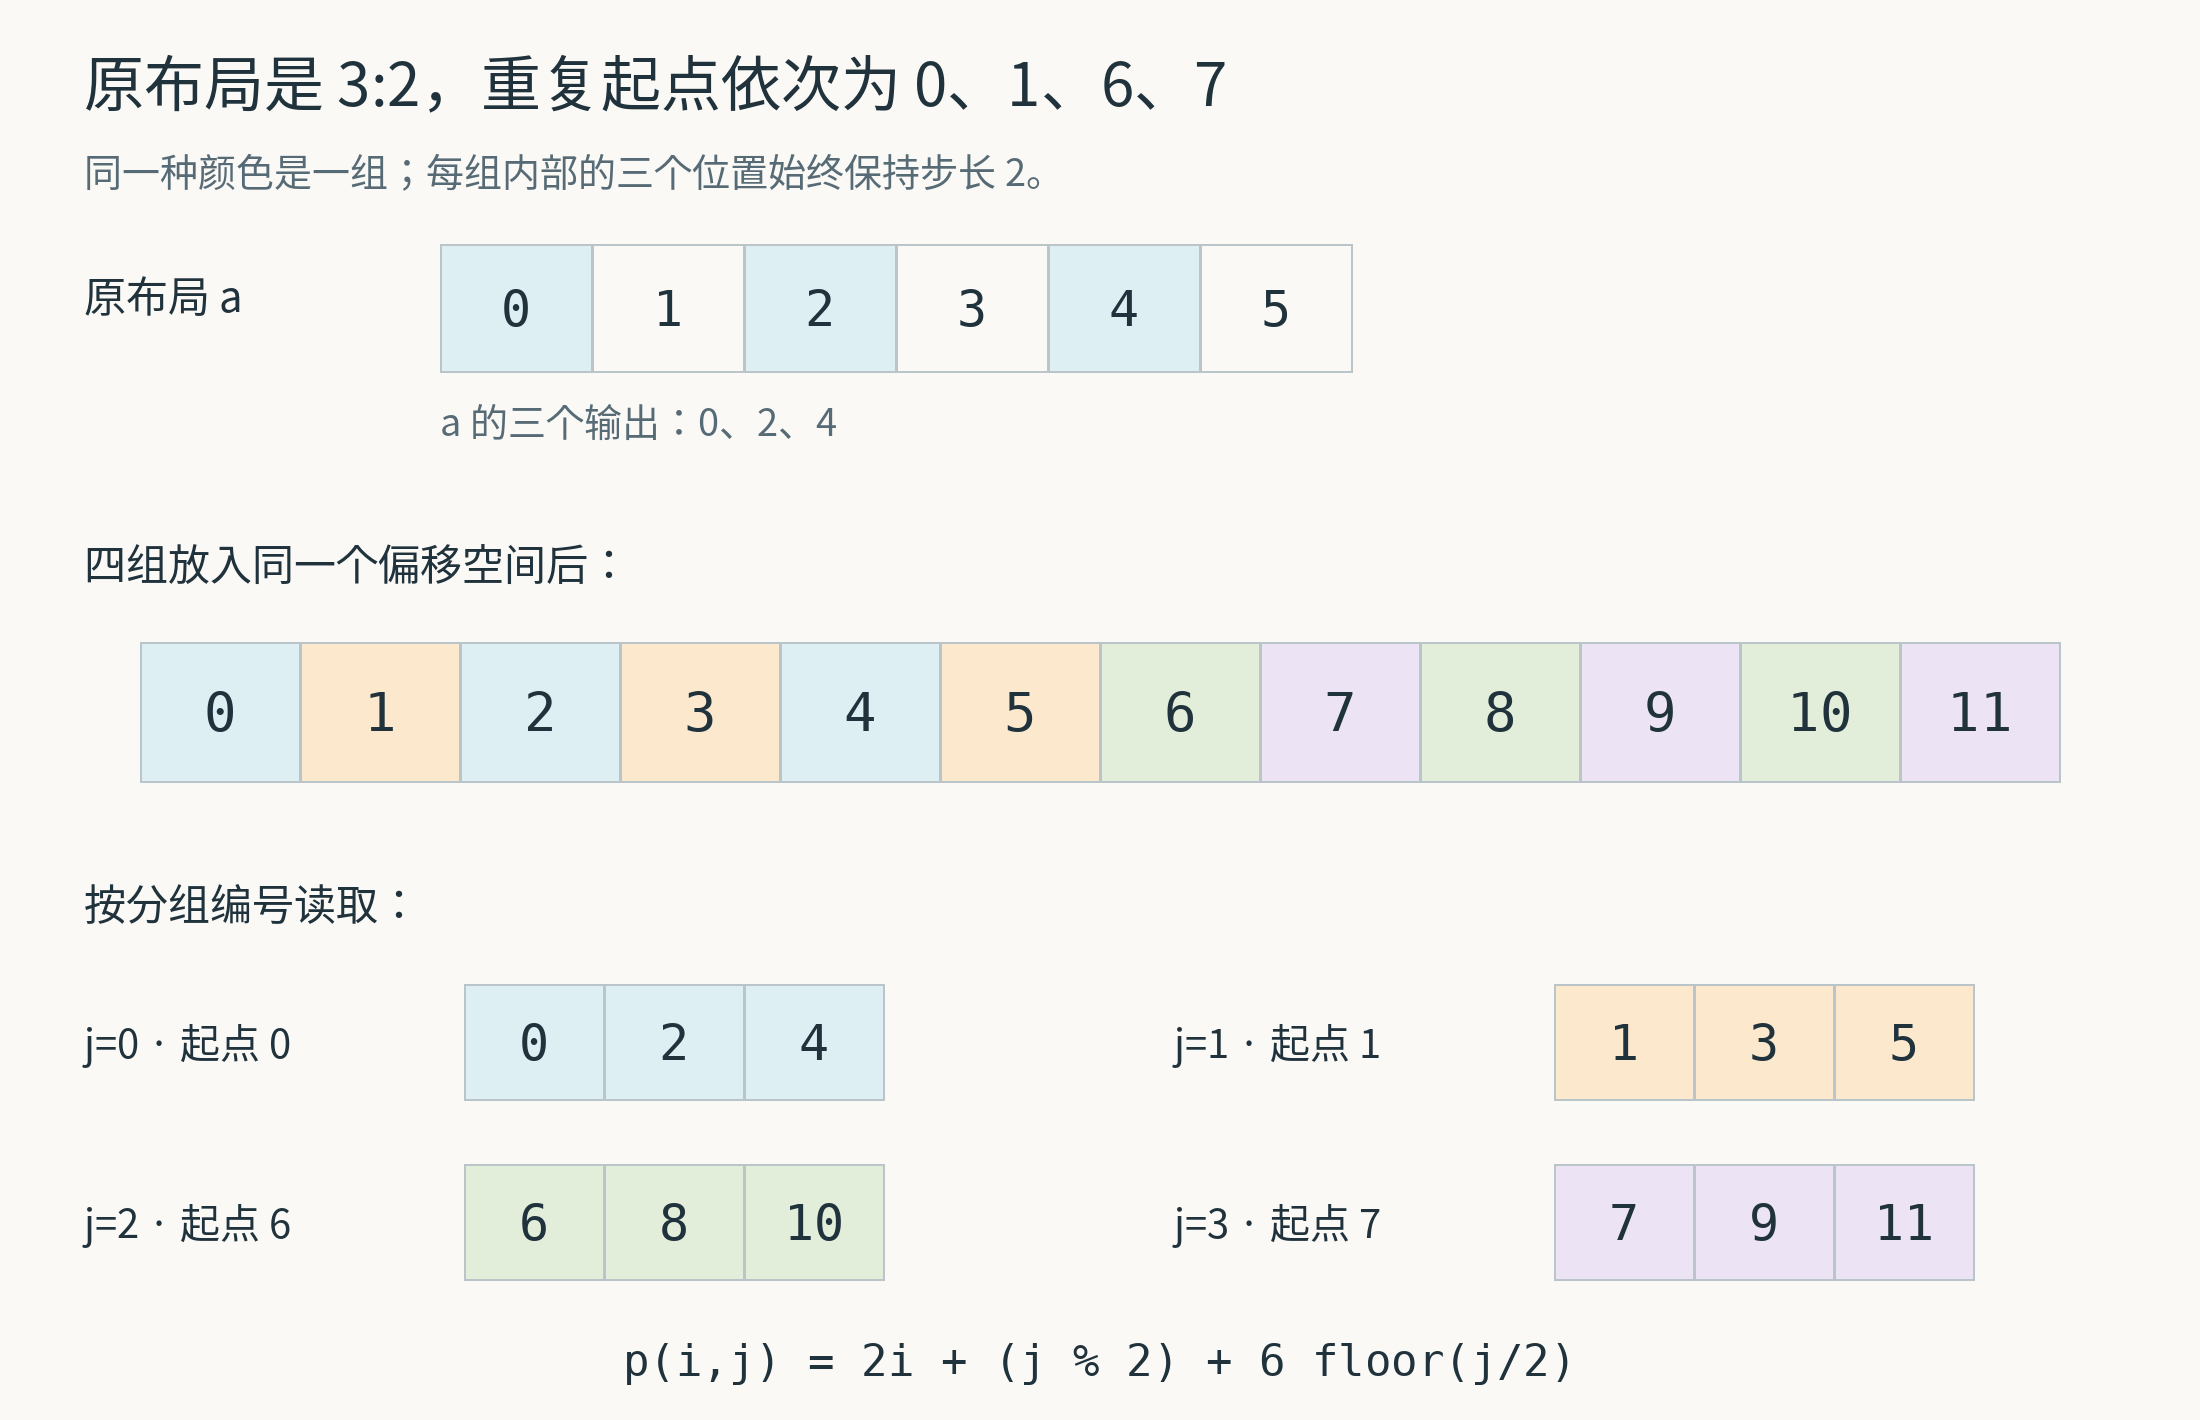
每一组内部仍然保持步长 2。变化的是组与组之间的起点:0、1、6、7,不再是等差数列。
因此结果的第二个 mode 需要拆成两层:
shape  = (3,(2,2))
stride = (2,(1,6))
将整数分组编号 j 拆成:
j0 = j % 2
j1 = j / 2      // 整数除法
就能得到:
p(i,j) = 2*i + j0 + 6*j1
CuTe 允许用整数访问一个嵌套 mode,分解时按第一个子 mode 优先递增。所以这里的 p(i,j) 与 p(i,make_coord(j%2,j/2)) 访问同一个位置。
注意三个不同的数量:size(a)=3,cosize(a)=5,按 3×2 得到的步长跨度是 6。对这个非负步长的例子,cosize 等于最大输出 4 加 1。重复起点不能简单写成这三个数中的任意一个乘以 j。
这一串起点从哪里来
当前仓库的核心实现只有这一行:
return make_layout(block, composition(complement(block), tiler));
若把互补布局记为 a*,这行代码对应的偏移公式就是 p(i,j) = a(i) + a*(b(j)):先由 b 选择重复位置,再加上 a 内部的偏移。
这里把前面的 a 称为 block,把 b 称为 tiler。可以分成三步读:
complement(block)找出与原布局配合的重复方向。composition(..., tiler)按第二个布局指定的数量和顺序,构造各组的起点。make_layout(block, ...)将组内布局与组间布局放进两个 mode;最终输出是两部分偏移之和。
对 3:1,打印出来的 complement 是 1:3。它末端的 stride 3 保留了向外扩展的规则,和 4:1 做 composition 后得到 4:3。
对 3:2,则有:
complement(3:2) = (2,1):(1,6)

composition((2,1):(1,6), 4:1)
    = (2,2):(1,6)

logical_product(3:2, 4:1)
    = (3,(2,2)):(2,(1,6))
complement 末端的大小虽然是 1,仍然保留了扩展步长 6;composition 会根据 tiler 的需要构造更大的结果。不能只看这个 1,就认为它只能描述一组。
这也解释了为什么先用空隙:原布局负责 0、2、4,互补方向先提供偏移 1,二者相加就覆盖了 1、3、5,随后再沿步长 6 扩展。
本文选择的是静态、非负步长、满足这些运算要求的布局。遇到广播或重复映射时,需要单独检查结果,不能套用“每组一定互不重叠”的直觉。
第二个布局还可以改变重复的顺序
再回到连续的 a=3:1,将第二个布局改成:
auto b = make_layout(make_shape(_2{},_2{}),
                     make_stride(_2{},_1{}));
auto p = logical_product(make_layout(_3{}), b);
整数编号 j=0,1,2,3 经过 b 后,得到 0,2,1,3。因此四组的起点依次为:
j                  0       1       2        3
b(j)               0       2       1        3
这一组的输出     [0 1 2] [6 7 8] [3 4 5] [9 10 11]
结果是 (3,(2,2)):(1,(6,3))。第二个参数既能指定重复多少次,也能指定按什么顺序重复。
把一组从三个元素换成一个 2×3 小矩阵
现在用同一组二维例子看其他 product。先定义一个行主序的小矩阵布局:
auto a = make_layout(make_shape(_2{}, _3{}),
                     make_stride(_3{}, _1{}));
// a = (2,3):(3,1)
坐标写作 (m,n),m 沿图中竖直方向增加,n 沿水平方向增加:
        n=0  n=1  n=2
m=0      0    1    2
m=1      3    4    5
再定义四组的排列:
auto b = make_layout(make_shape(_2{}, _2{}),
                     make_stride(_1{}, _2{}));
// b = (2,2):(1,2)
b 的坐标记为 (p,q),输出为 p+2*q。它描述一个 2×2 的分组网格,先沿 p 方向增加,再沿 q 方向增加。
直接做 product:
auto lp = logical_product(a,b);
得到:
shape  = ((2,3),(2,2))
stride = ((3,1),(6,12))

lp((m,n),(p,q)) = 3*m + n + 6*p + 12*q
原来的二维 a 完整地留在第一个 mode 中,二维 b 对应第二个 mode。最外层仍然只有两个 mode,因此 rank(lp)=2。
例如,最后一组 (p,q)=(1,1),组内坐标 (m,n)=(1,2):
lp(make_coord(1,2), make_coord(1,1)); // 3+2+6+12 = 23
这里有一个很关键的接口含义:logical_product(Layout, Layout) 的两个参数即使都是二维,结果也先组织成“整块坐标、分组坐标”这两个 mode。 它不会自动把两个 m 方向合成新的 m,把两个 n 方向合成新的 n。
想得到后面那种矩阵坐标,就要用到 blocked_product。不过在此之前,先看看几种只调整分组方式的 product。
zipped、tiled、flat:同一条公式,坐标怎样传进去
继续使用刚才的 a 和 b:
auto zp = zipped_product(a,b);
auto tp = tiled_product(a,b);
auto fp = flat_product(a,b);
实际结果如下:
| 操作 | Shape | Stride | 顶层 rank |
|---|---|---|---|
logical_product(a,b) | ((2,3),(2,2)) | ((3,1),(6,12)) | 2 |
zipped_product(a,b) | ((2,3),(2,2)) | ((3,1),(6,12)) | 2 |
tiled_product(a,b) | ((2,3),2,2) | ((3,1),6,12) | 3 |
flat_product(a,b) | (2,3,2,2) | (3,1,6,12) | 4 |
它们都能表达刚才的偏移 23,只是坐标的括号位置不同:
lp(make_coord(1,2), make_coord(1,1)); // 23
zp(make_coord(1,2), make_coord(1,1)); // 23
tp(make_coord(1,2), 1, 1);           // 23
fp(1, 2, 1, 1);                    // 23
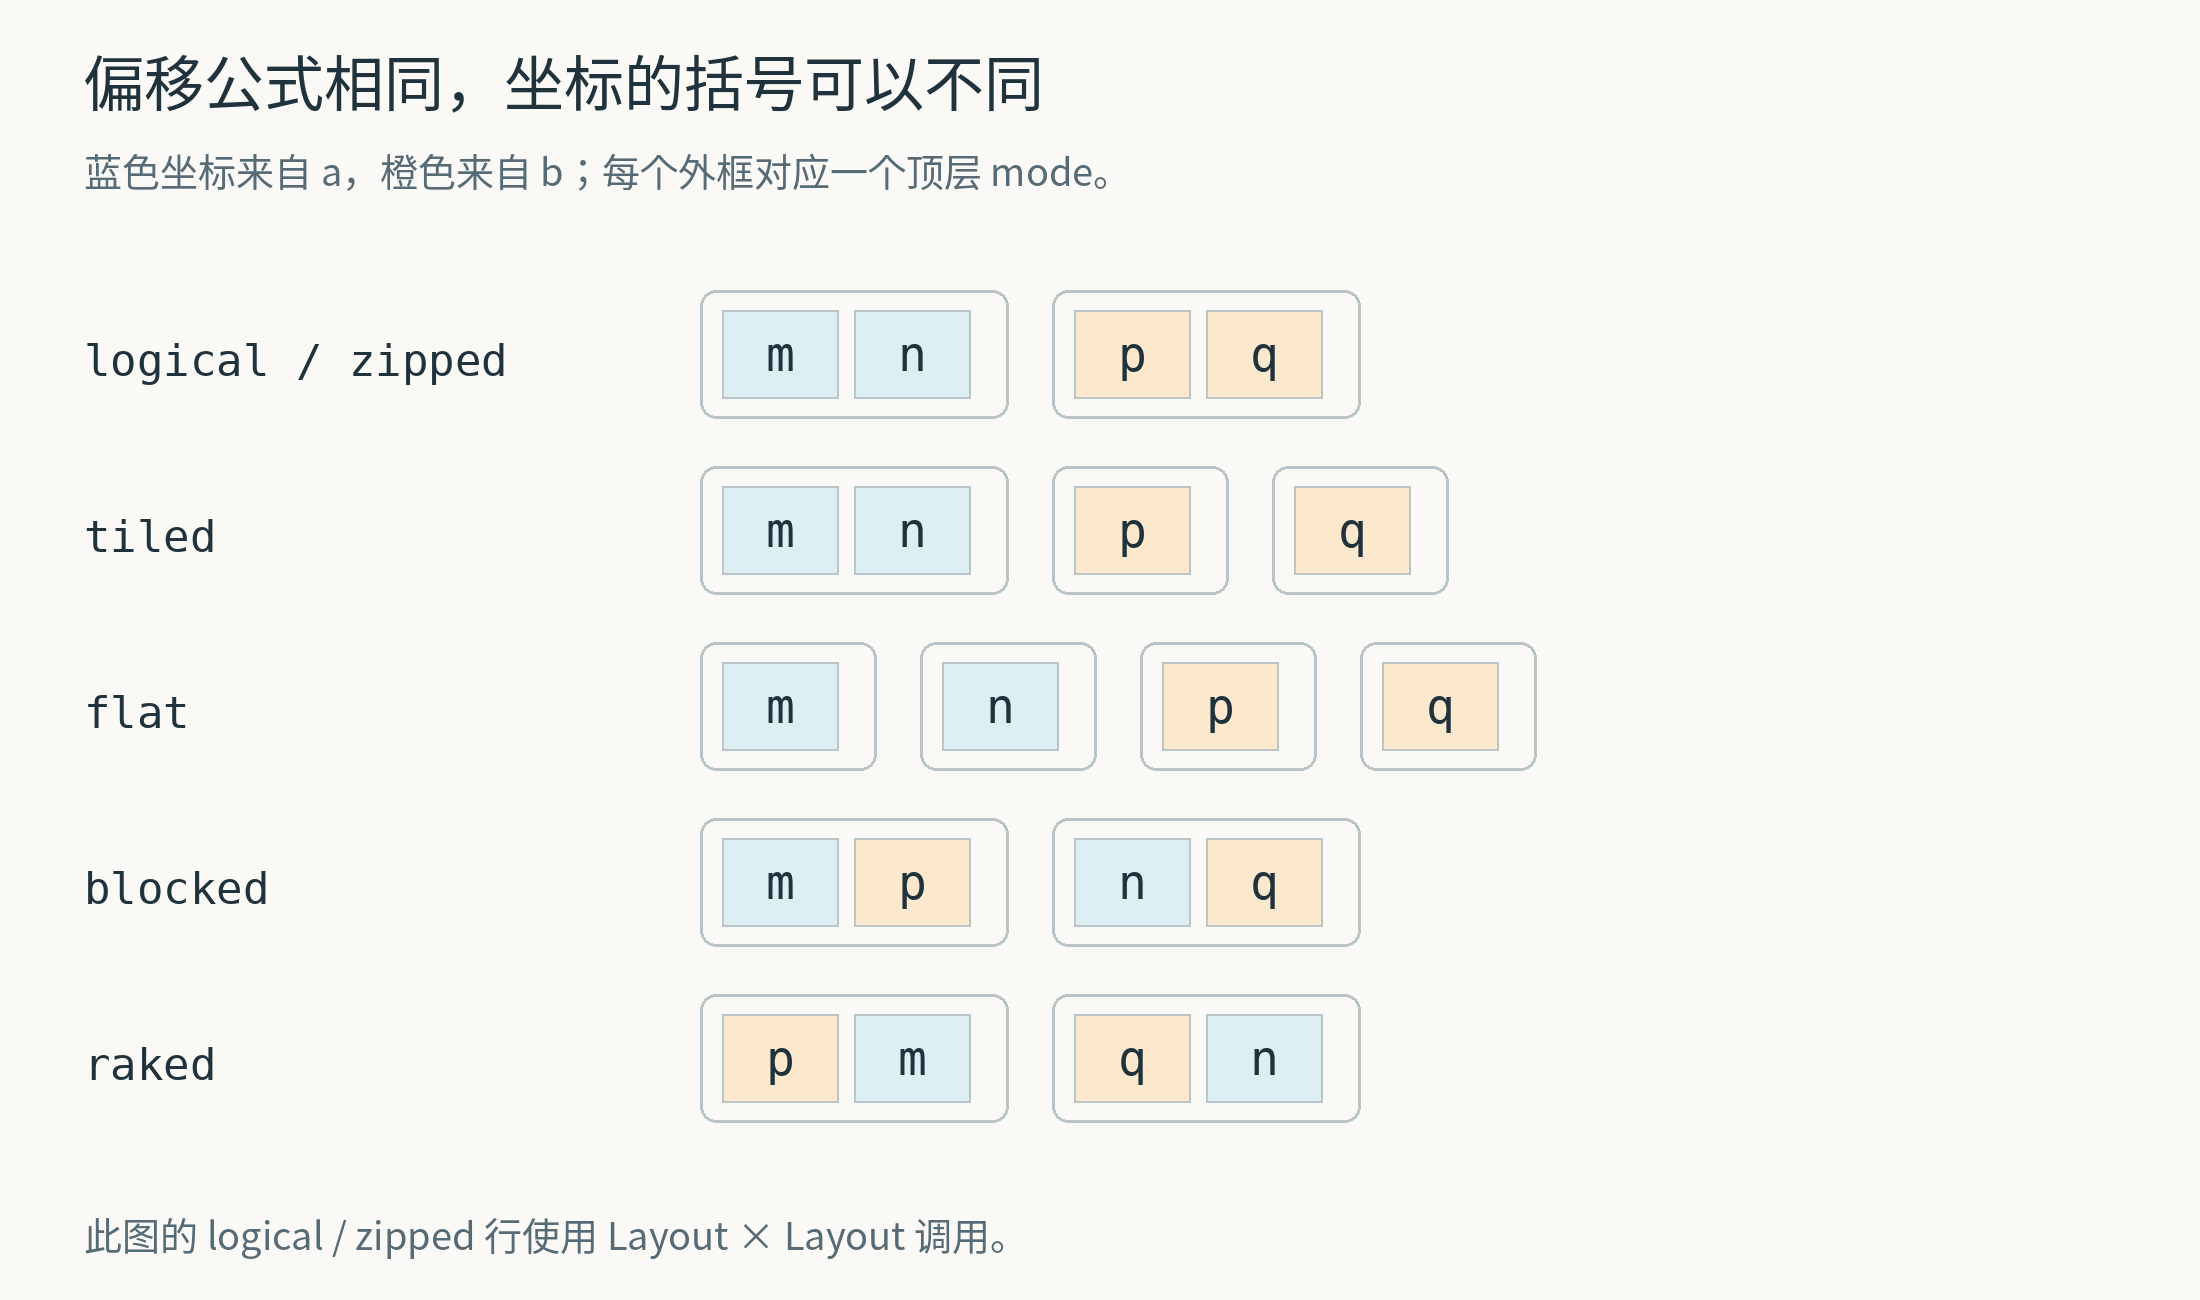
zipped_product:把块内坐标放在一起,把分组坐标放在一起
zipped_product 的目标结构是:
(整块的坐标, 分组的坐标)
在当前 Layout × Layout 例子中,logical_product 已经返回这种结构,因此 zipped_product 的结果与它相同。
这个相同很容易造成误解。zipped_product 真正需要整理括号的情况,是后文的“逐 mode product”;不能据此认为这两个 API 永远等价。
当后续代码想用一个坐标整体选择某一组时,这种结构比较顺手。例如,构造 tensor 后固定第二个 mode:
// data 指向容量足够的已有存储。
auto t = make_tensor(data, zp);
auto one_block = t(_, make_coord(1,0));
// one_block 的布局为 (2,3):(3,1),起点已经移动到偏移 6。
tiled_product:保留完整小块,展开外面的重复方向
tiled_product 在 zipped 结果的基础上,只展开第二个 mode:
((m,n),(p,q)) → ((m,n),p,q)
这样既保留了整块的内部结构,又能分别控制两个重复方向。代码若要在 p、q 上循环,而每次处理完整的 2×3 小块,就适合这种接口。
例如 t(_,p,q) 会选中对应的小块,后面不必再为 (p,q) 加一层 make_coord。
flat_product:把两边的顶层子 mode 都展开
flat_product 再将第一边也展开:
((m,n),(p,q)) → (m,n,p,q)
现在四个坐标可以分别访问或切片。
这里的 flat 指的是展开两边的 mode,不表示把整个布局变成一维,也不保证内存连续。如果 m 本身还有更深的嵌套,这个操作也不会递归拆掉所有括号。
同样是 logical_product,传 tuple 为什么会变样
CuTe 还有另一条调用路径:第二个参数可以是由多个 tiler 组成的 tuple。make_tile 构造的就是这种对象。
这两种写法需要分清:
// 一个二维 Layout:作为整体参与 product。
logical_product(a, make_layout(make_shape(_2{},_2{})));

// 两个独立 tiler:分别对 a 的第 0、1 个 mode 做 product。
logical_product(a, make_tile(_2{},_2{}));
它们的区别不在数字 2,而在第二个参数的类型。
源码中的 tuple 分支会逐 mode 调用 logical_product。因此,对一个有 M、N 两个 mode 的布局,输出结构变成:
logical_product : ((M,RepM), (N,RepN))
zipped_product  : ((M,N), (RepM,RepN))
tiled_product   : ((M,N), RepM, RepN)
flat_product    : (M, N, RepM, RepN)
这就是 zipped 中“收拢”的具体含义:从每个 mode 中取出原块的部分,放到第一个大 mode;把重复的部分收进第二个大 mode。
但是,逐 mode product 有个麻烦:每个轴自己的 complement,并不知道其他轴占用了哪些位置。
对本文的 a=(2,3):(3,1),直接使用 make_tile(_2{},_2{}),会得到:
((2,2),(3,2)):((3,1),(1,3))
这里两个不同的坐标会得到同一个偏移:
坐标 ((0,1),(0,0)) → 1
坐标 ((0,0),(1,0)) → 1
如果目标是构造四个互不重叠的小块,这个结果就不符合要求。不能把“四组,沿两个轴各重复两次”直接翻译成两个整数 2。
若确实要用逐 mode 的方式构造前面那四组,可以这样写:
auto by_mode = make_tile(
    make_layout(_2{}, _3{}),  // 对 a 的 m mode 做 product
    make_layout(_2{}, _4{})); // 对 a 的 n mode 做 product

auto ml = logical_product(a, by_mode);
auto mz = zipped_product(a, by_mode);
auto mt = tiled_product(a, by_mode);
auto mf = flat_product(a, by_mode);
其中 m 轴的 complement 是 (3,1):(1,6),与 2:3 复合后,重复偏移为 0、6;n 轴的 complement 是 1:3,与 2:4 复合后,重复偏移为 0、12。
于是结果为:
ml = ((2,2),(3,2)):((3,6),(1,12))
mz = ((2,3),(2,2)):((3,1),(6,12))
mt = ((2,3),2,2):((3,1),6,12)
mf = (2,3,2,2):(3,1,6,12)
同一组逻辑坐标在四种接口中的对应关系是:
ml(make_coord(m,p), make_coord(n,q));
mz(make_coord(m,n), make_coord(p,q));
mt(make_coord(m,n), p, q);
mf(m, n, p, q);
// 都等于 3*m+n+6*p+12*q。
为了拼四个小块,却要事先算出 stride 3 和 4,确实不够自然。需要按矩阵方向组织整块时,CuTe 提供了更直接的写法。
blocked_product:把小矩阵排成一张大矩阵
还是那两个 Layout:
a = (2,3):(3,1)   一个 2×3 小块
b = (2,2):(1,2)   小块按 2×2 排列
直接调用:
auto bp = blocked_product(a,b);
结果为:
shape  = ((2,2),(3,2))
stride = ((3,6),(1,12))
第一个 mode 将 a 的 m 和 b 的 p 放在一起;第二个 mode 将 n 和 q 放在一起:
logical_product 的坐标:((m,n),(p,q))
blocked_product 的坐标:((m,p),(n,q))
对每个嵌套 mode 使用整数坐标时,里面的第一个子 mode 优先增加。因此新的矩阵坐标是:
M = m + 2*p       // 2 来自 a 的 m 大小
N = n + 3*q       // 3 来自 a 的 n 大小
它表达的是一张 4×6 的大矩阵。每个原来的 2×3 小块,在逻辑矩阵中都保持成块。
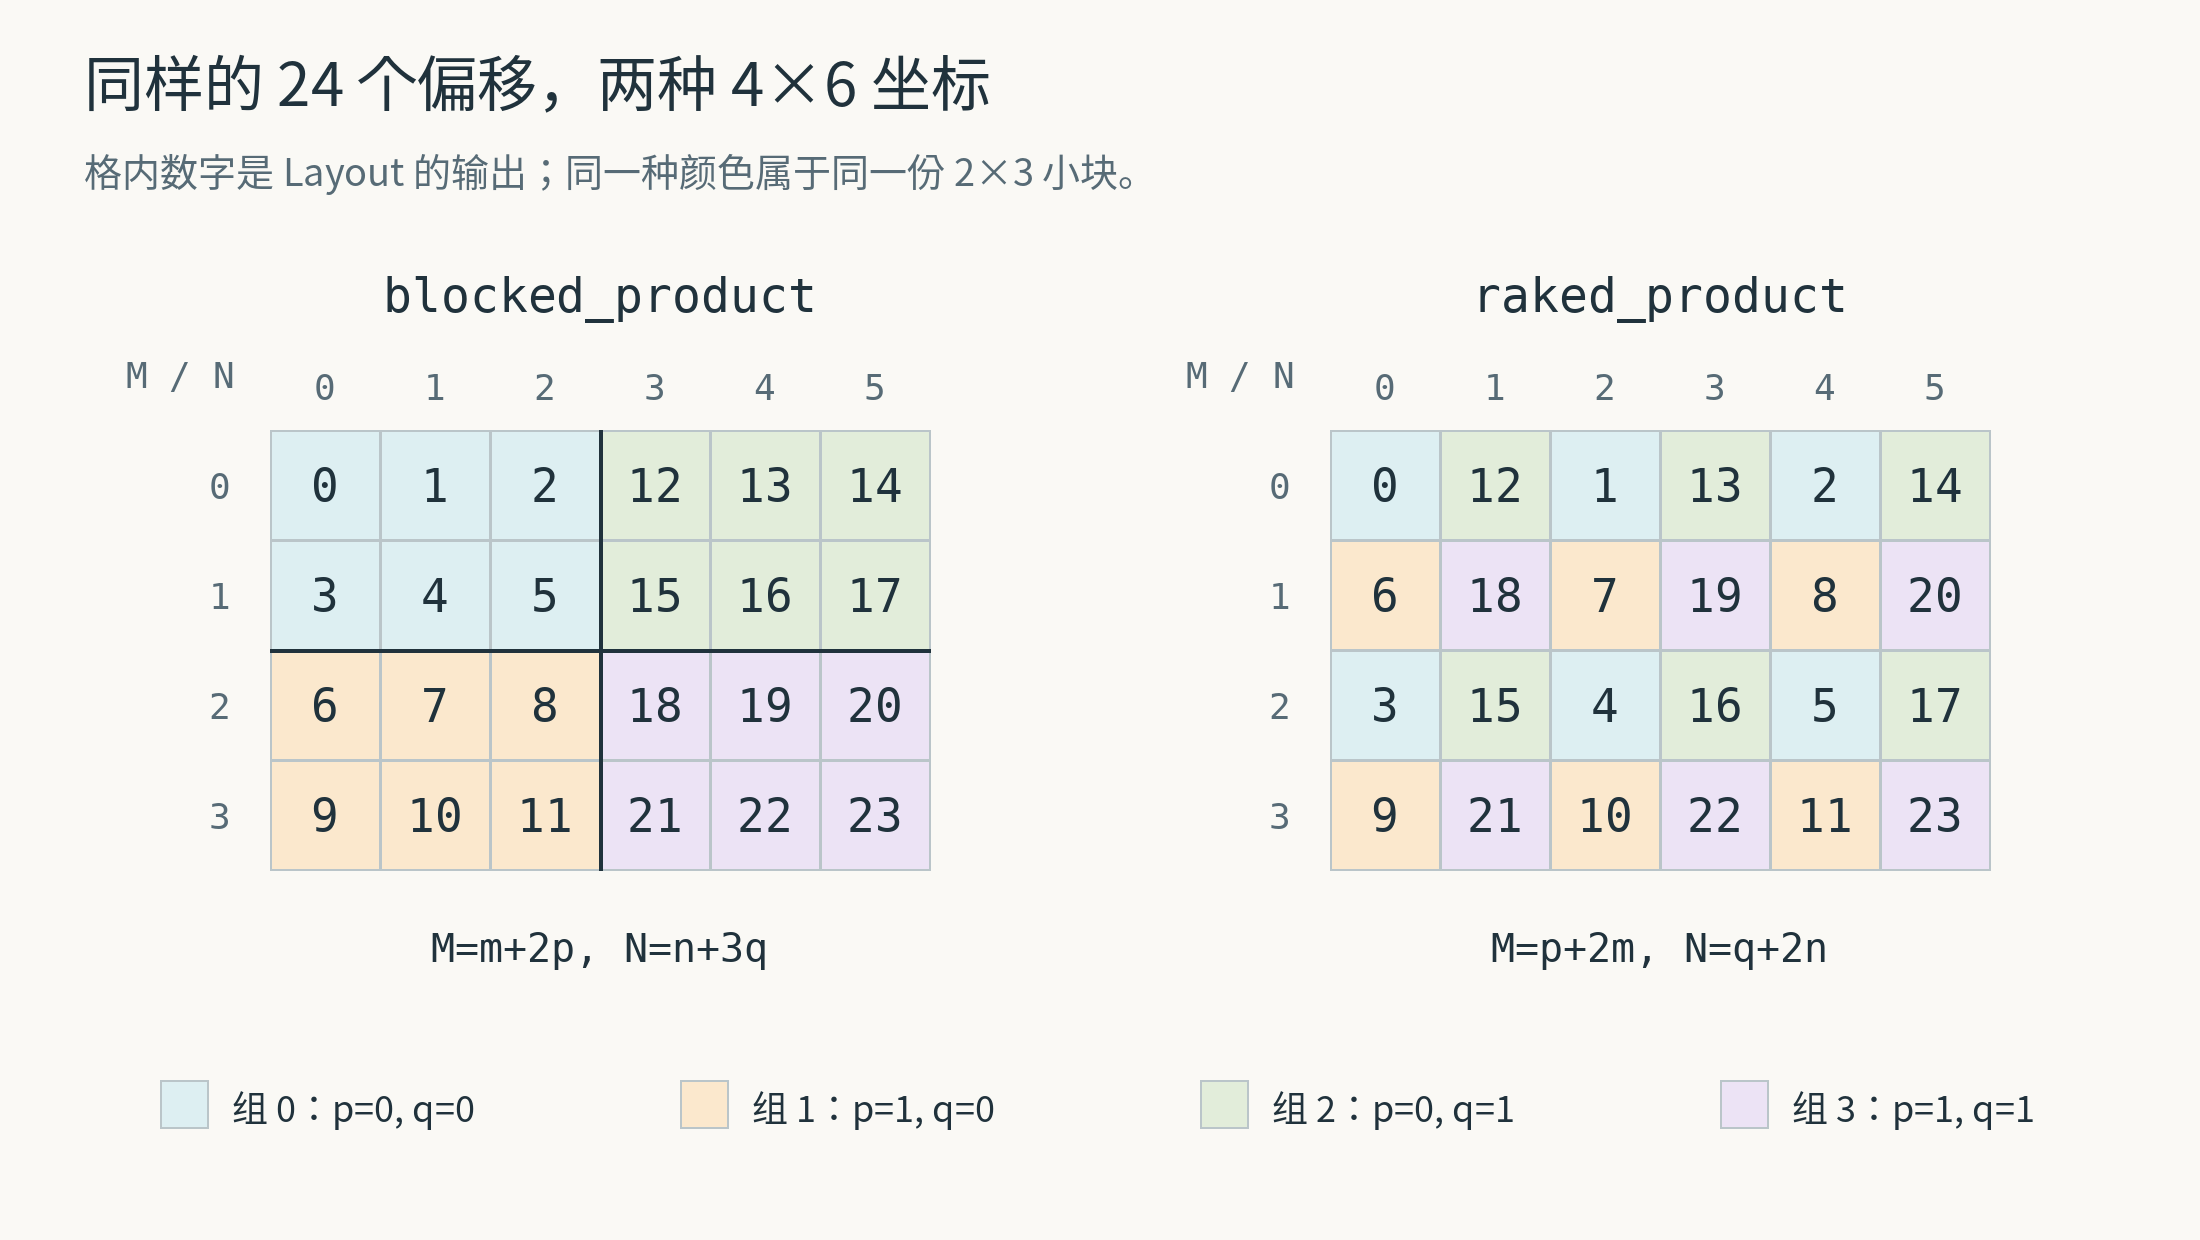
先看图的左半边:颜色表示同一组,格内数字是输出偏移。第一组为 0~5,第二组为 6~11,依此类推。
注意图中第一行是 0,1,2,12,13,14。把小块按矩阵坐标拼起来,并不自动得到普通行主序的大矩阵。 本例的存储仍然一块接一块,而小块本身按 b 的次序摆放。
这正是 blocked 的用途:分别定义块内规则与块间规则,再按对应轴将它们组织起来。它可以表达分块存储,也可以表达其他层次结构;具体含义取决于 Layout 的输出是地址、线程编号,还是别的索引。
从源码看,这个过程也很直接:
// 省略将两个输入补到相同 rank 的步骤。
auto result = logical_product(block, tiler);
return zip(get<0>(result), get<1>(result));
它先对两个完整 Layout 做 product,再将对应的 mode 配对。因此不需要像前面的逐 mode 写法那样,手动为每个轴推导 tiler stride。
raked_product:交换每个方向内部的快慢次序
把函数名换一下:
auto rp = raked_product(a,b);
结果为:
shape  = ((2,2),(2,3))
stride = ((6,3),(12,1))
和 blocked 对照着看:
blocked:((m,p),(n,q))
raked:  ((p,m),(q,n))
每个方向都把第二个布局的坐标放在里面,先递增:
M = p + 2*m       // 2 来自 b 的 p 大小
N = q + 2*n       // 2 来自 b 的 q 大小
再看上图右半边:属于同一个小块的元素被隔开,穿插进其他小块之间。这种排列也常被称为交错或 cyclic 分布。
可以固定一个具体元素验证。取 m=1,n=2,p=0,q=0,它的输出偏移始终为 5:
在 blocked 的大矩阵中,它位于 (M,N)=(1,2)。
在 raked 的大矩阵中,它位于 (M,N)=(2,4)。
两者使用的偏移项仍然是同一组 3*m+n+6*p+12*q,但这些子坐标与大矩阵坐标的对应关系改变了。因此不能给 blocked 和 raked 传入同一个大矩阵坐标,再期待输出相同。
raked_product 的实现只交换了最后 zip 的顺序:
auto result = logical_product(block, tiler);
return zip(get<1>(result), get<0>(result));
blocked 和 raked 都会按需要将较低 rank 的输入补到相同 rank,再配对各轴。它们输出的顶层 rank 是两个输入顶层 rank 的较大值;本文两个输入都是 rank 2,所以结果也都是 rank 2。
这些区别在 Copy 和 MMA 中有什么用
make_tiled_copy 为什么使用 raked_product
在 make_tiled_copy 中,可以找到这几行:
auto layout_mn = raked_product(thr_layout, val_layout);
auto layout_tv = right_inverse(layout_mn)
    .with_shape(make_shape(size(thr_layout), size(val_layout)));
auto tiler = product_each(shape(layout_mn));
这里的 Layout 输出暂时不是数据地址:thr_layout 输出线程编号,val_layout 输出线程内的值编号。product 先把两种编号合成一个编码,再通过逆映射,回答“某个线程的某个值,应该位于 tile 的哪里”。
先用一个只有 4 个线程、每线程 2 个值的例子看这层关系。这个数字只是为了画图,不代表 GPU warp 只有 4 个线程。
auto thr_layout = make_layout(_4{}); // 线程编号 t=0~3
auto val_layout = make_layout(_2{}); // 每线程值编号 v=0~1

auto rb = blocked_product(thr_layout, val_layout);
auto rr = raked_product(thr_layout, val_layout);
两种布局输出的都是编码 t+4*v。区别在于 tile 的位置 x 怎样分解:
blocked:x = t + 4*v
raked:  x = v + 2*t
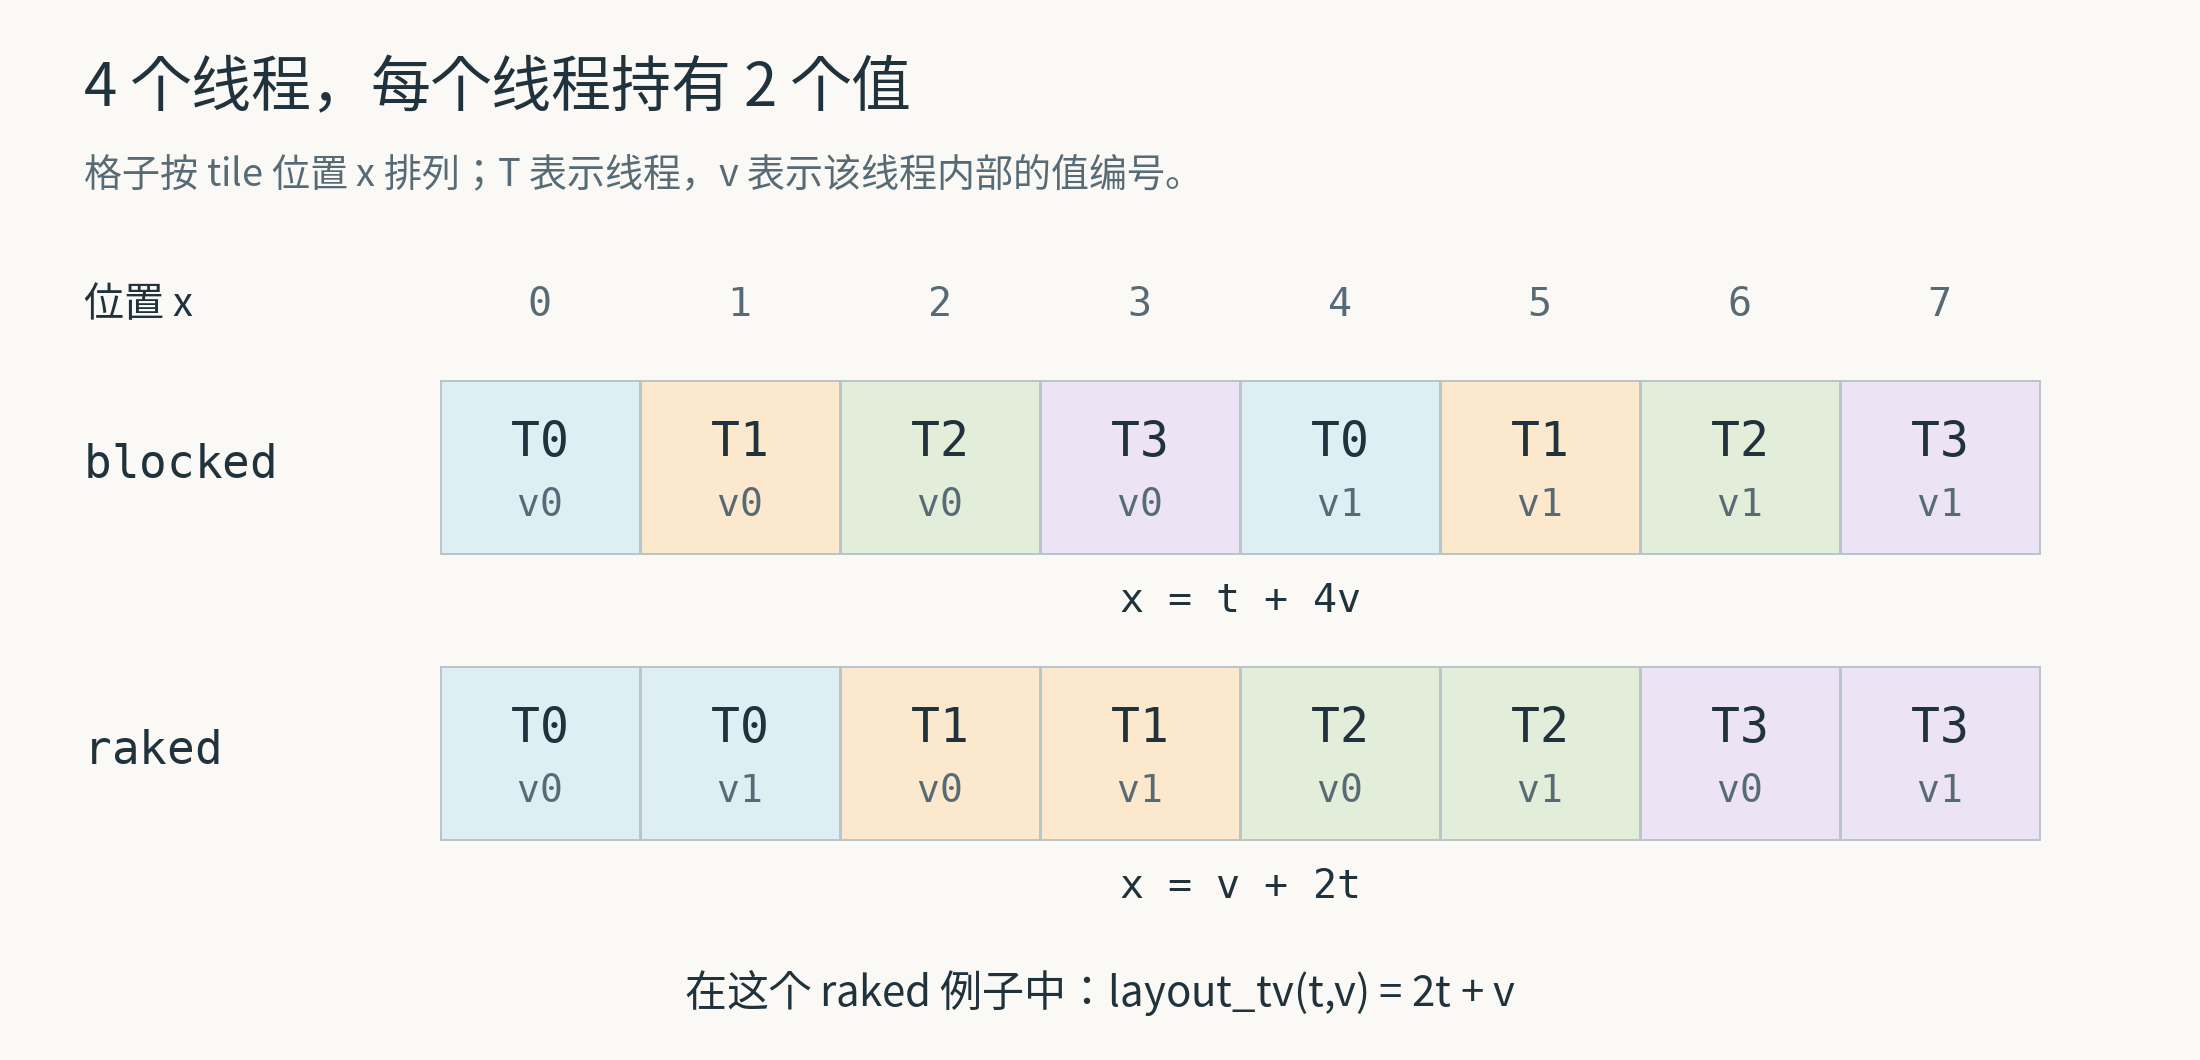
在 raked 的这组参数下,线程 0 负责位置 0、1,线程 1 负责 2、3,依此类推。做逆映射后,就得到:
layout_tv(t,v) = 2*t + v
shape  = (4,2)
stride = (2,1)
这让代码可以通过 (线程编号,线程内值编号) 找到 tile 位置,再对源 tensor 和目的 tensor 分区。
此处特别容易混淆映射的方向:layout_mn 从位置得到 TV 编码,layout_tv 才从 TV 编号回到位置。它们还要接上实际 tensor 的布局,才能得到内存地址。
raked 也不直接保证访存合并或没有 bank conflict。这些性质还取决于线程和值布局、Copy Atom,以及实际数据的存储方式。
TiledMMA 为什么使用 tiled_product
MMA 是矩阵乘加指令。CuTe 用 MMA Atom 封装一条指令及其线程分工,再用 TiledMMA 将多个 Atom 组织起来。以 SM80 常见的 MMA 为例,一条指令由一个 warp 的 32 个线程协作执行。
TiledMMA 中有这样的定义:
using ThrLayoutVMNK =
    decltype(tiled_product(AtomThrID{}, AtomLayoutMNK{}));
一个 MMA Atom 已经规定了内部参与线程的布局。假设它是 32:1,再沿 M、N 各安排两组 Atom,K 方向一组:
auto threads = tiled_product(
    make_layout(_32{}),
    make_layout(make_shape(_2{},_2{},_1{})));
结果是:
shape  = (32,2,2,1)
stride = (1,32,64,0)

线程编号 = lane + 32*p + 64*q
这四个 mode 分别表示 Atom 内线程,以及 M、N、K 方向的 Atom 分组。K 大小为 1,它的 stride 为 0。
这里选择 tiled,是因为后续代码要保留 Atom 的内部线程 mode,同时分别操作 M、N、K 这三个方向。若停在 logical/zipped 的结构,后三个方向会包在同一个 mode 里。
retile 里的 logical_product 又在组织什么
retile 中有一段:
logical_product(make_layout(V), right_inverse(frg_layout_mn))
第一边为当前 fragment 的 V 个值编号;第二边描述要从哪些 fragment 位置收集值。product 将两层编号组织成一张表,后续再按 Copy Atom 的宽度分组。
例如,仅为演示这一步,设 V=4,收集布局为 2:2:
auto ids = logical_product(make_layout(_4{}),
                           make_layout(_2{},_2{}));
// (4,2):(1,8)
两组逻辑编号为:
第 0 组:0 1 2 3
第 1 组:8 9 10 11
第二组跳过了 4~7。这说明第二边的 stride 有实际含义,不能只保留“总共 8 个值”,就把结果改写成 8:1。
这些编号之后还要与输入 fragment 的布局复合,才会找到实际寄存器槽位。这正是阅读 retile 时,应该区分“收集编号”和“存储偏移”的原因。
已经知道目标形状时,用 tile_to_shape
有时需要表达的只是:把 2×3 的块扩展到 4×6。这种情况下可以直接写目标形状:
auto result = tile_to_shape(a, make_shape(_4{},_6{}));
在本文的例子中,它会算出重复形状 (2,2),默认先沿第一个方向安排重复,再调用 blocked product。结果与前面的 blocked_product(a,b) 相同:
((2,2),(3,2)):((3,6),(1,12))
它的便利之处是不用手动计算重复次数。当目标不再是 4×6 时,只需修改目标形状。
对于本文这种静态形状,目标各轴要能被原块各轴整除;这里 4/2=2、6/3=2。如果需要改变各方向的重复先后,还可以通过第三个参数指定 mode order。
实际写代码时,怎样选择
| 想让后续代码怎样访问 | 可以先考虑 | 留意什么 |
|---|---|---|
| 从整块布局和重复布局构造两层结构 | logical_product | 第二个参数是 Layout 还是 tuple,会改变运算方式 |
| 用两个大坐标分别选择块内位置与分组 | zipped_product | 将逐 mode product 的两类坐标收拢 |
| 保留完整块,分别操作外部重复方向 | tiled_product | 只展开 zipped 结果的第二个 mode |
| 分别操作两边的各个顶层子 mode | flat_product | 不等于一维化或递归 flatten |
| 按相同矩阵轴拼接小块 | blocked_product | 每个轴中,原块坐标先变化 |
| 让不同组沿每个轴交错排列 | raked_product | 每个轴中,第二个布局坐标先变化 |
| 已知最终形状,希望自动推导重复次数 | tile_to_shape | 静态目标形状需要满足整除要求 |
读到一段 product 代码时,可以先拿一个具体元素检查:它在原块里的坐标是什么,属于哪一组,新接口怎样接收这几个坐标,最后得到多少偏移。把这一条路径走通,再看大段模板代码就会容易得多。
配套程序与源码位置
本文所有具体布局都由配套程序编译打印,并逐坐标核对手推公式,共检查 510 项映射。程序只在 CPU 上运行,不需要 GPU:
# 在 CUTLASS 仓库根目录执行。
nvcc -std=c++17 -I include cute_layout_product_trace.cu \
    -o /tmp/cute_layout_product_trace
/tmp/cute_layout_product_trace
正文省略了打印结果中用于表示静态常量的下划线,例如 _3:_1 写成 3:1。图中的数值来自同一个程序输出的布局,完整记录见运行结果。
相关实现:
- layout.hpp:
complement、各种 product,以及tile_to_shape。 - copy_atom.hpp:
make_tiled_copy中的 raked product,以及 retile 中的 logical product。 - mma_atom.hpp:
ThrLayoutVMNK的 tiled product。 - logical_product 单元测试:包含带步长和嵌套形状的更多组合。
- CuTe 官方布局代数教程:可对照阅读原始图解。
本文依据本地 CUTLASS 提交 0b55a2f691d69981583568fd9eb69687b1f0de8a 的 C++ 实现。仓库教程中的 product 片段仍使用带 cotarget 的 complement 写法,而当前源码使用 complement(block);上文的精确打印结果以当前源码为准。